IDC 影像发现 · 从元数据过滤到可追溯下载清单
@public/imaging-data-commons
查看空间 →组织NCI IDC公开影像的元数据发现、队列筛选、只读SQL、序列清单、许可和引用,再将明确对象版本交给下载或本地分析。区分MCP/REST、本地索引和云桶职责,检查实际过滤警告、分页截断、数据release与索引build,避免静默漏取或混用历史修订。
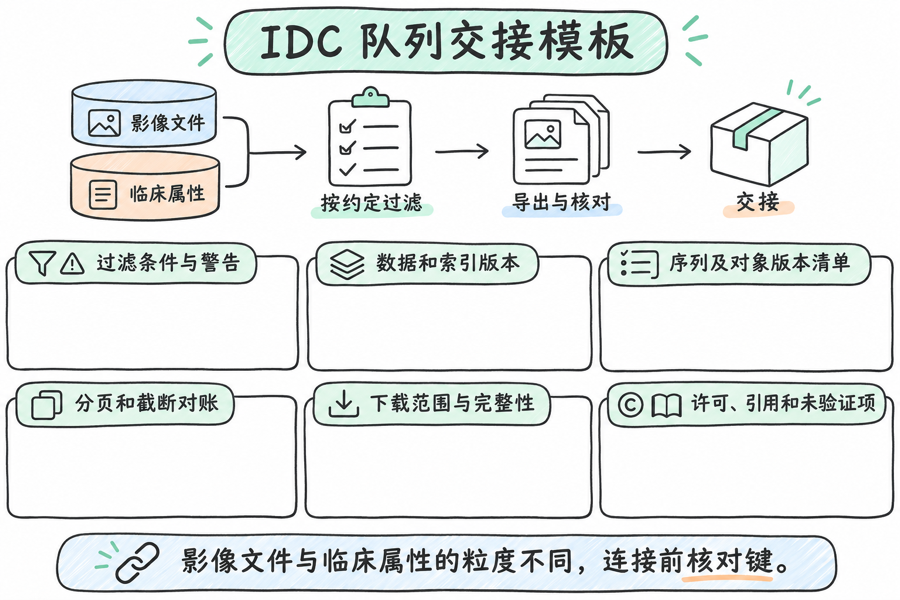
能力与使用条件
适用场景
- 发现公开放射/病理影像并构建条件明确的研究队列
- 在MCP/REST与本地索引间交接同一版本序列
- 核对清单完整性、下载范围及逐序列许可/引用
输入要求
- 研究问题、collection/模态/部位等经过发现确认的筛选条件
- 所选IDC数据release、索引build、Series UID和CRDC对象版本
- 需要的元数据或像素范围、存储预算及使用许可要求
输出结果
- 记录实际过滤/警告与规模的队列元数据或清单
- 对账序列、对象版本和下载完整性要求
- 许可明细、引用、viewer链接及版本/覆盖局限交接
前置条件
- 来源Skill1.8/上游1.8.1、内容MIT,作者Andrey Fedorov;idc-index0.12.5、index-data24.2.2、v24及API3.0.0b3是来源快照,官方文档已可能更新,使用时读实际版本/schema
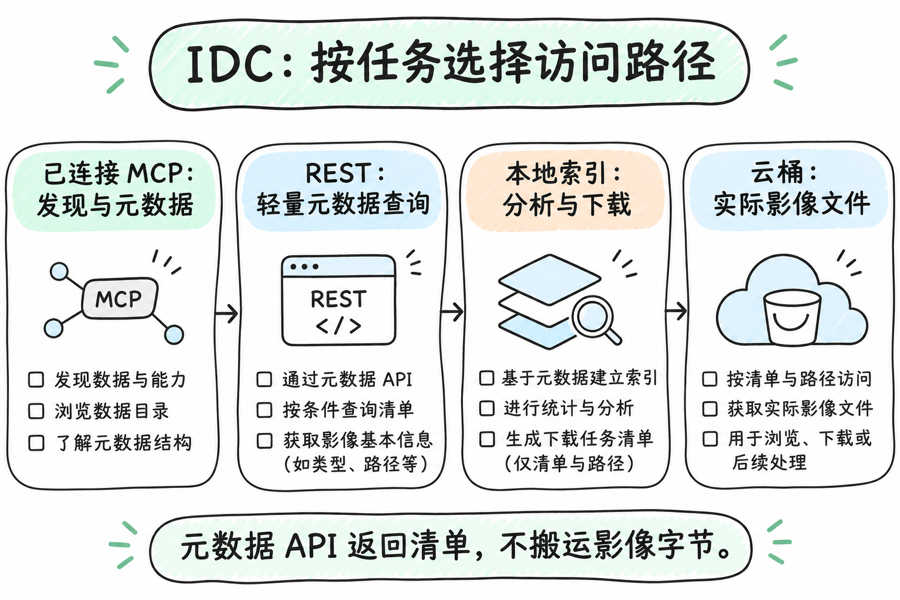
- 公共IDC元数据/云桶无需账号,部分Google Healthcare/BigQuery路径另需GCP权限;按任务选现有MCP、轻量REST或本地索引,不将网页Portal当程序API
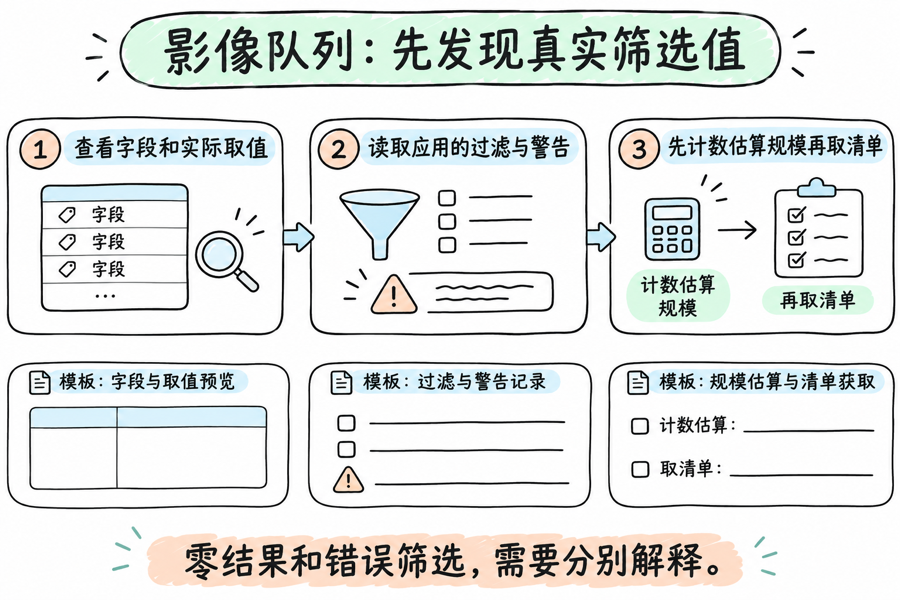
- 核对实际字段、值和粒度:collection内PatientID不能假设全局唯一,series/instance、collection/clinical与历史版本不同;下载前估算规模、资源和获授权范围
不适用场景与限制
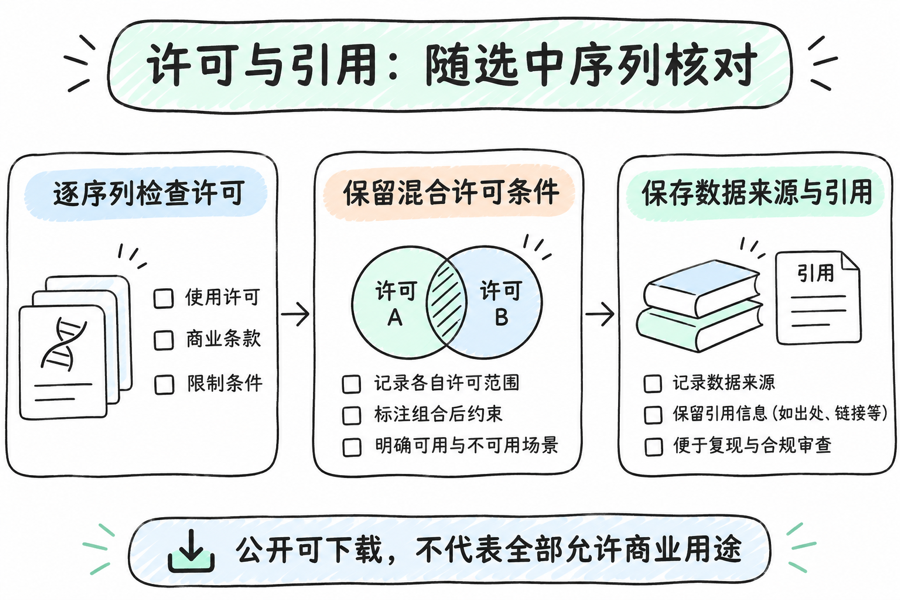
- MCP/REST负责元数据、URL/manifest等,影像字节由云桶到客户端;viewer URL不等于已下载,公开可用也不代表许可统一,逐序列核对CC BY/NC等条件及引用
- 来源v3 beta契约可能变动,filters形状、字段取值、warnings/filters_applied都要检查;HTTP成功也可能有被忽略谓词,零匹配和大小写错误不能混解释
- SQL/clinical/manifest的上限和分页不同,truncated或清单行数需对账;文本manifest可能静默截断,不能仅凭一页或HTTP200声称全量,必要时分区或用固定Parquet
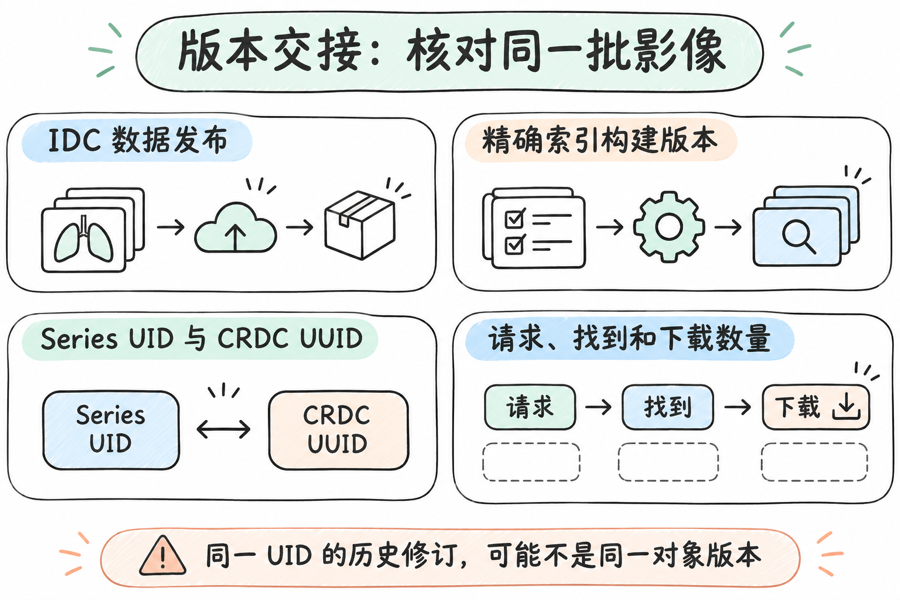
- API与本地索引release/build可能不同,旧索引可漏掉新UID,匹配数据release仍不证明元数据build相同;下载前检查请求减已找到集合及CRDC UUID,历史UID可对应不同修订
- 索引只是部分元数据,临床表并非跨collection统一,seg/ann引用源序列与一般同UID连接不同,不能猜字段或把缺列当缺影像;历史对象需确切对象版本
- 本地下载函数参数次序/selector优先级按版本核对,来源不接收DataFrame直接当selection;CRDC文件名不是SOP UID,DICOM强制读取不是格式/解码验证,记录实际完整性
- 全文读核心与rest_api_guide(分段完整读取),核对IDC官方访问/REST说明;未连接IDC MCP、执行队列SQL、下载/读取像素或申请云账号,图仅说明发现和交接
- 下载链接为固定提交的完整仓库快照,使用其中 skills/imaging-data-commons 目录。配图是说明性示例。
说明性示例
- 为条件明确的研究队列先查询当前版本、表结构与真实筛选值,读取应用过滤及warnings后计数,再分页获取Series UID和CRDC UUID。交给本地下载前核对索引build与对象版本、请求与已找到数量,保存逐序列许可和引用;如清单截断或旧索引漏项,报告部分状态而不声称完成。
资料依据
- https://github.com/k-dense-ai/scientific-agent-skills/blob/ec59a29a03d5c40f73ab40878df04860bc00e876/skills/imaging-data-commons/SKILL.md
- https://github.com/k-dense-ai/scientific-agent-skills/blob/ec59a29a03d5c40f73ab40878df04860bc00e876/skills/imaging-data-commons/SKILL.md
外部资源
内容由外部网站提供,平台不保证第三方文件的完整性、可用性或安全性。
外部文件的访问权限由第三方管理,本站无法限制其地址的访问。