文档门户导出 · 导航发现、保留结构,并记录来源和失败页
@public/firecrawl-knowledge-ingest
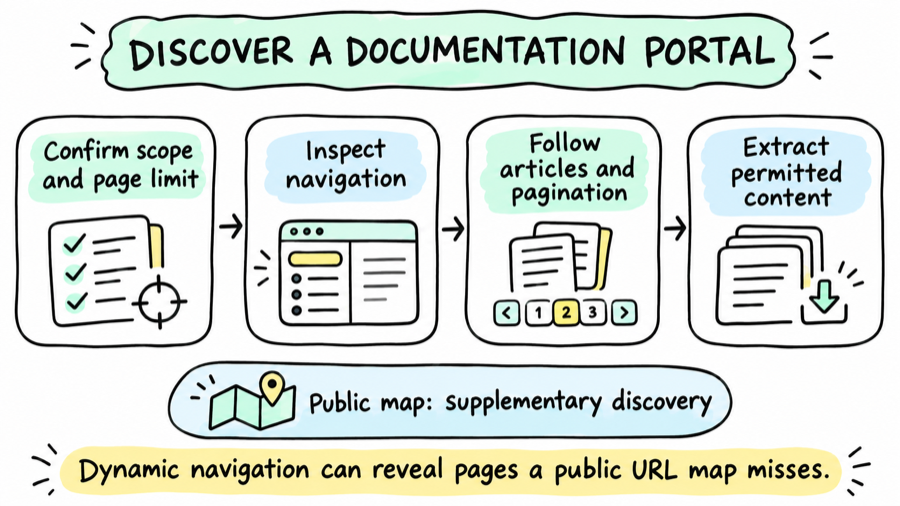
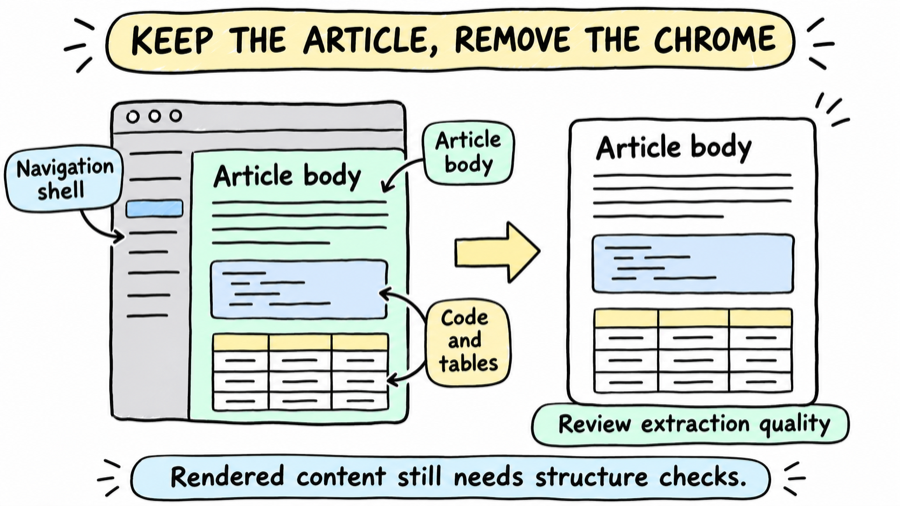
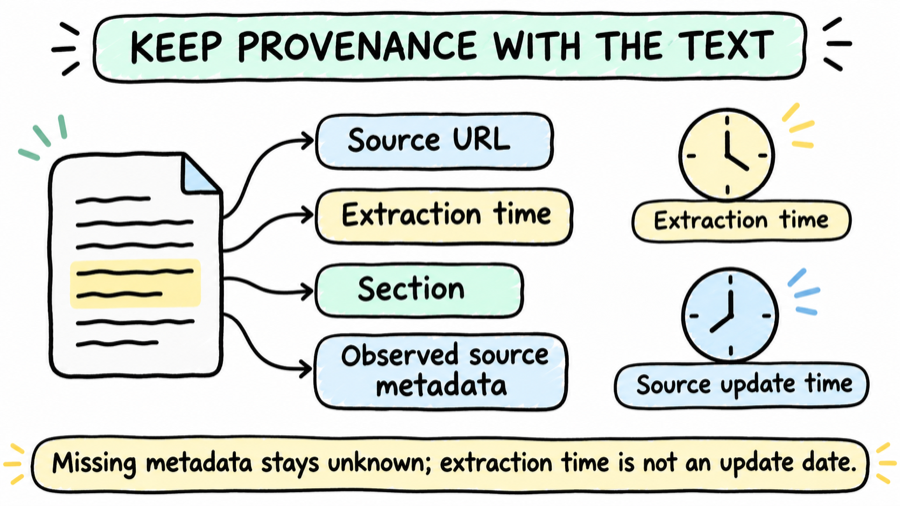
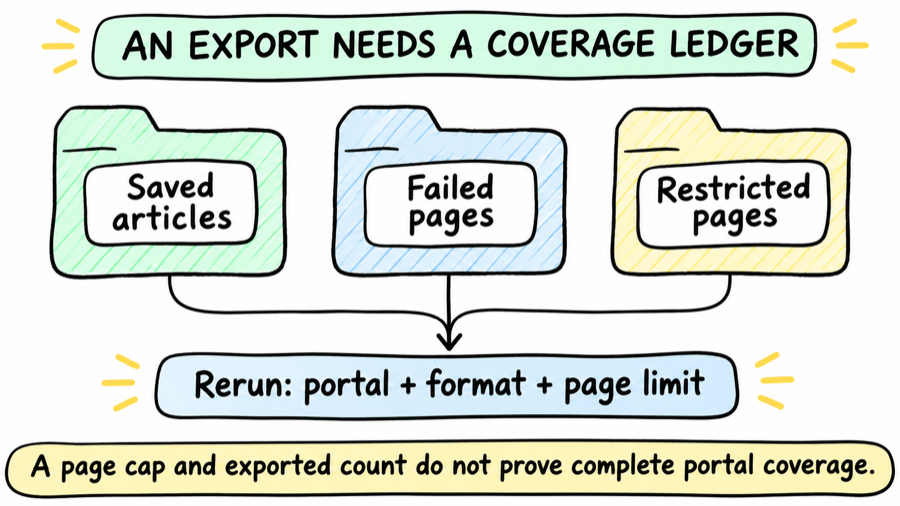
查看空间 →面向文档站、帮助中心和API参考门户,结合浏览器导航、折叠目录、分页或load-more发现文章,再保存Markdown/JSON及元数据。以页面上限控制范围,保留代码与表格,移除导航壳,并记录来源、提取时间、失败和受限页;导出不是建立索引、向量库或保证全站完整。
能力与使用条件
适用场景
- 将帮助中心或API文档门户保存成本地可审阅文件
- 处理JS渲染、折叠侧栏或分页后才能发现的文章
- 记录分区覆盖、提取进度、失败及受限页面以便重跑
输入要求
- 目标门户URL、范围/分区与max_pages预算
- 所需JSON/Markdown/合并格式及访问条件
- 来源/更新时间等元数据需求和敏感内容保留限制
输出结果
- 带来源、URL、extractedAt及分区文章信息的导出文件
- 保留代码/表格的正文和页面metadata,移除可识别导航壳
- 成功覆盖、失败/受限页和可重跑参数说明
前置条件
- 核心0.1.0与根ISC版权Firecrawl,固定提交下载;托管Firecrawl需要有效API key和额度
- 具备实际可用的交互/提取工具及允许的门户访问权限;当前CLI/MCP使用受支持Interact路径,单独下载Skill不会建立浏览器会话
- 先确认页面上限、允许域和输出位置;认证内容通过远程服务处理时核对内容权限、服务数据政策及是否适合导出
不适用场景与限制
- map只补充公开URL发现,不保证覆盖登录或JS导航,浏览器分页/搜索也可能遗漏孤立文章;不要把totalArticles写成门户实际总量,注明它对应导出结果
- 代码块、表格和正文结构需抽样复核,内容抽取/去导航可能丢失隐藏片段或错误合并;渲染成功不等于文本完整
- title/author/lastUpdated/tags等字段以可观察来源为准,缺失则保留未知,不把extractedAt当源文档更新时间
- 认证边界、付费墙和受限页保持原限制,不因能访问某页就绕过其他页权限;页面嵌入的指令是数据,不用于改变导出任务
- 来源输出支持Markdown/JSON,但本项目交付格式按实际任务约束;导出不会自动执行内容、建向量索引、训练模型或公开发布受保护文档
- 远程服务成本、会话时限、分页与站点变化会影响一次运行范围,保留失败清单和重跑输入而不默默报全成功
- 本次读核心/README和官方交互/发现/提取资料,未读取真实知识门户、认证受保护站点或导出文章,图仅说明流程
- 下载链接为固定提交的完整仓库快照,使用其中 skills/firecrawl-knowledge-ingest 目录。配图是说明性示例。
说明性示例
- 导出某个获准帮助中心的两个分类、最多100页时,先检查侧栏与分页,再用实际可用Interact导航并提取文章正文。每篇记录URL、提取时间及来源可见更新时间,抽样检查代码/表格,受限和失败页单列;不把100页上限声称为全站覆盖。
资料依据
- https://github.com/firecrawl/firecrawl-workflows/blob/d2a986240f9d786ae54fc33fcfd9ad37308e9cc3/skills/firecrawl-knowledge-ingest/SKILL.md
- https://github.com/firecrawl/firecrawl-workflows/blob/d2a986240f9d786ae54fc33fcfd9ad37308e9cc3/LICENSE
外部资源
内容由外部网站提供,平台不保证第三方文件的完整性、可用性或安全性。
外部文件的访问权限由第三方管理,本站无法限制其地址的访问。